SUSE Observability 中部分 Service 显示 Critical
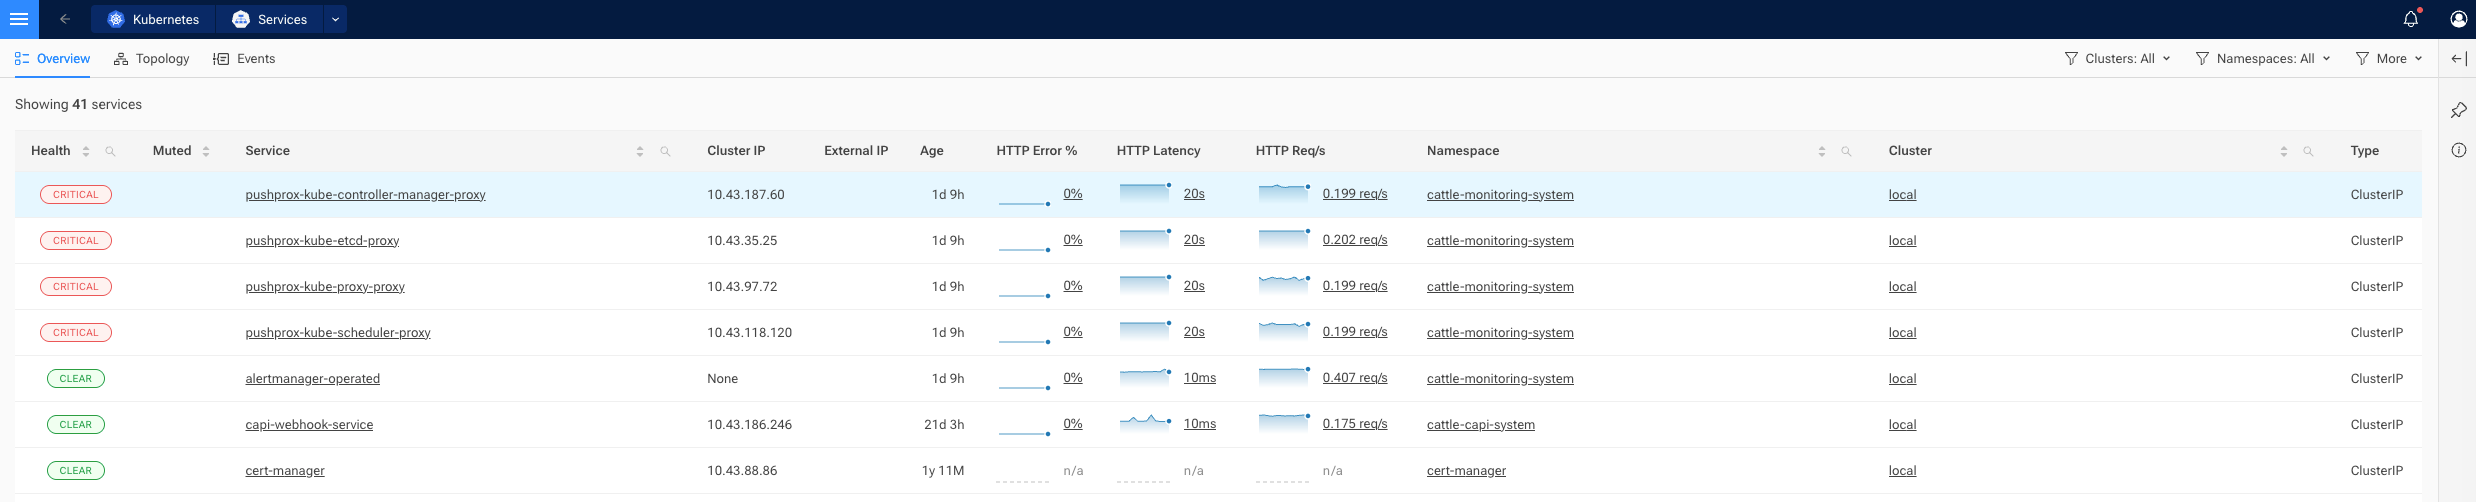
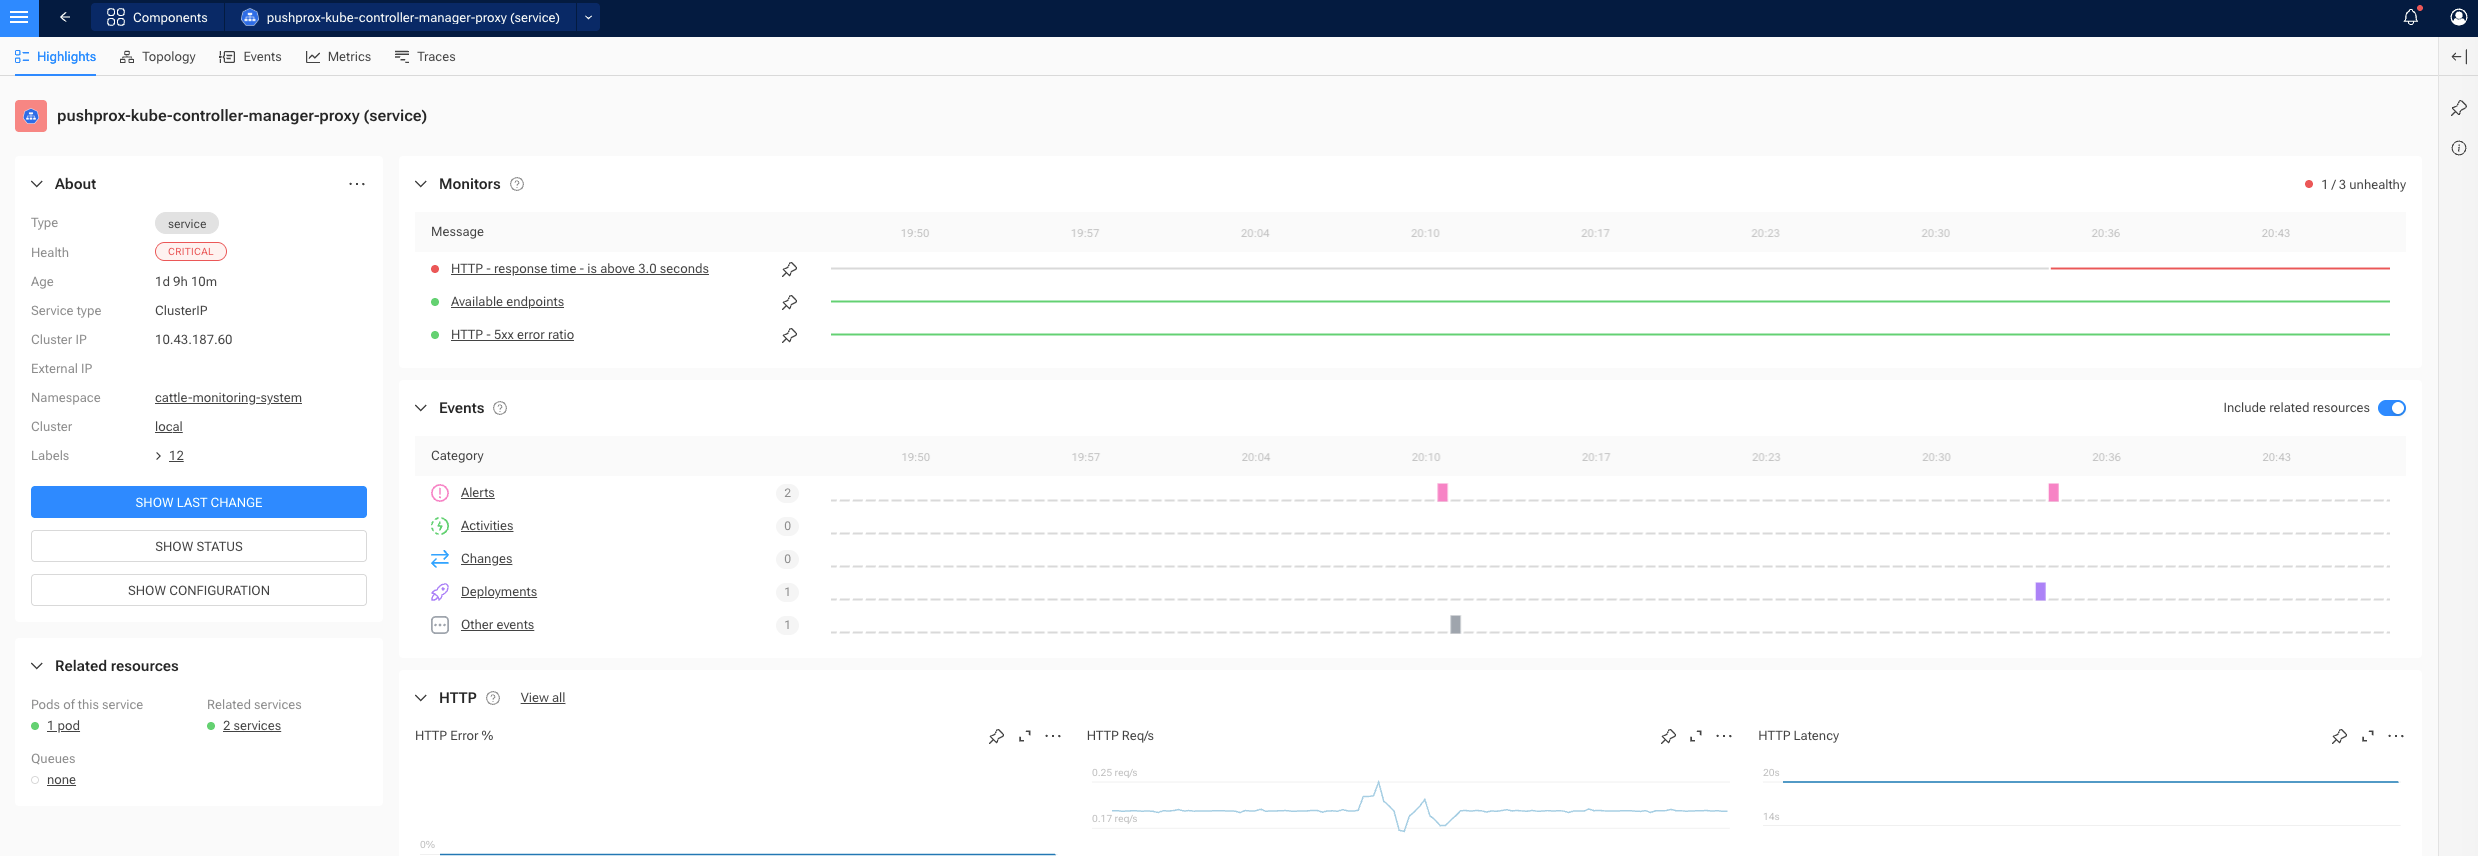
在 SUSE Observability 中,发现部分 Service 被标记为 Critical,但服务本身运行正常,实际请求也未出现响应时间过长的问题。
环境信息
- SUSE O11y:v2.12.0
- SUSE O11y Agent:v1.7.19
根本原因
问题的主要原因是,现有的高延迟请求排除机制未能完整识别部分长时间运行的 HTTP 请求,导致这些请求被计入普通 HTTP 请求的响应时间,从而触发延迟 Monitor 告警。
SUSE O11y v2.12.0 和 Agent v1.7.19 已包含针对 Kubernetes Watch 和 WebSocket 的相关修复:https://documentation.suse.com/cloudnative/suse-observability/latest/en/setup/release-notes/v2.8.0.html#_agent_bug_fixes
但现有的 Watch 识别规则仅覆盖特定的 HTTP/1.1 请求,无法完整识别服务自身的 Watch 请求、代理路径以及 HTTP/2 等长连接场景。
当这些长连接请求产生约 20 秒的 P95 延迟,且未携带 known_high_latency="true" 标签时,就无法被现有机制过滤,最终超过 prime-kubernetes Monitor 默认的 3 秒延迟阈值,导致 Service 被标记为 Critical。
目前的检测条件为:
- HTTP 请求方法必须为
GET。 - 请求路径必须以
/api开头。 - 请求的前约 1350 字节中必须包含字面字符串
watch=true。 - 仅支持 HTTP/1.1 请求,包括 Socket Filter 和 TLS uprobes。
相关判断逻辑如下:
1 | packet_type == HTTP_REQUEST && method == HTTP_GET |
当前识别机制存在以下限制:
- HTTP/2: HTTP/2 Parser 尚未实现 Watch 请求检测逻辑,因此通过 HTTP/2 建立的 Watch 请求,其整个 Stream 的持续时间都会被计入 HTTP 响应时间。
watch=1: 不符合现有watch=true的匹配条件,因此无法被识别。- 非 GET 请求: 不符合 HTTP 请求方法的匹配条件,因此无法被识别。
- SSE 或 Chunked Stream: 如果未返回
101 Switching Protocols,整个长连接的持续时间仍会被计入 HTTP 响应时间。 - Long Polling(长轮询): 长轮询请求的等待时间同样会被计入 HTTP 响应时间。
已知受影响的场景
Rancher Kubernetes 代理路径
通过 Rancher 发起的 Kubernetes Watch 请求使用 /k8s/clusters/<cluster-id>/... 路径,例如:
1 | GET /k8s/clusters/local/api/v1/namespaces/default/pods?watch=true&timeoutSeconds=15 |
该请求正常返回 HTTP 200,持续时间约为 15 秒,属于 Kubernetes Watch 的正常行为。
但是,由于请求路径不以 /api 开头,不符合现有 Watch 请求的识别条件,因此不会被标记为 known_high_latency="true",导致其持续时间仍被计入 HTTP 响应延迟,并参与延迟 Monitor 的告警计算。
PushProx 长轮询
PushProx Client 通过 POST /poll 请求等待下一次 Prometheus 抓取任务。由于抓取间隔为 30 秒,/poll 请求的平均持续时间也约为 30 秒,属于正常的长轮询行为。
但是,由于该请求不符合现有 Watch 请求的排除条件,其等待时间仍被计入 HTTP 响应时间,导致以下 Service 触发 Critical 告警:
pushprox-kube-controller-manager-proxypushprox-kube-etcd-proxypushprox-kube-proxy-proxypushprox-kube-scheduler-proxy
实际上,相关 Prometheus Target 均处于 Up 状态,实际抓取耗时仅约为 13–39 毫秒,未出现明显的抓取延迟。
然而,这四个 Proxy Service 在 SUSE O11y 中的 P95 响应延迟仍显示为约 20 秒。由于这些长轮询请求未携带 known_high_latency="true" 标签,无法被现有高延迟排除机制过滤,因此仍参与延迟 Monitor 的告警计算,最终导致 Service 被错误标记为 Critical。
Workaround
可以通过在受影响的 Service 上添加 Annotation,禁用对应的 HTTP Response Time Monitor,以避免正常的长连接请求持续触发误报。
方式一:修改 Service YAML
1 | metadata: |
方式二:通过 kubectl 添加 Annotation
1 | kubectl -n cattle-system annotate service <service_name> 'monitor.kubernetes-v2.stackstate.io/http-response-time={"enabled":false}' |
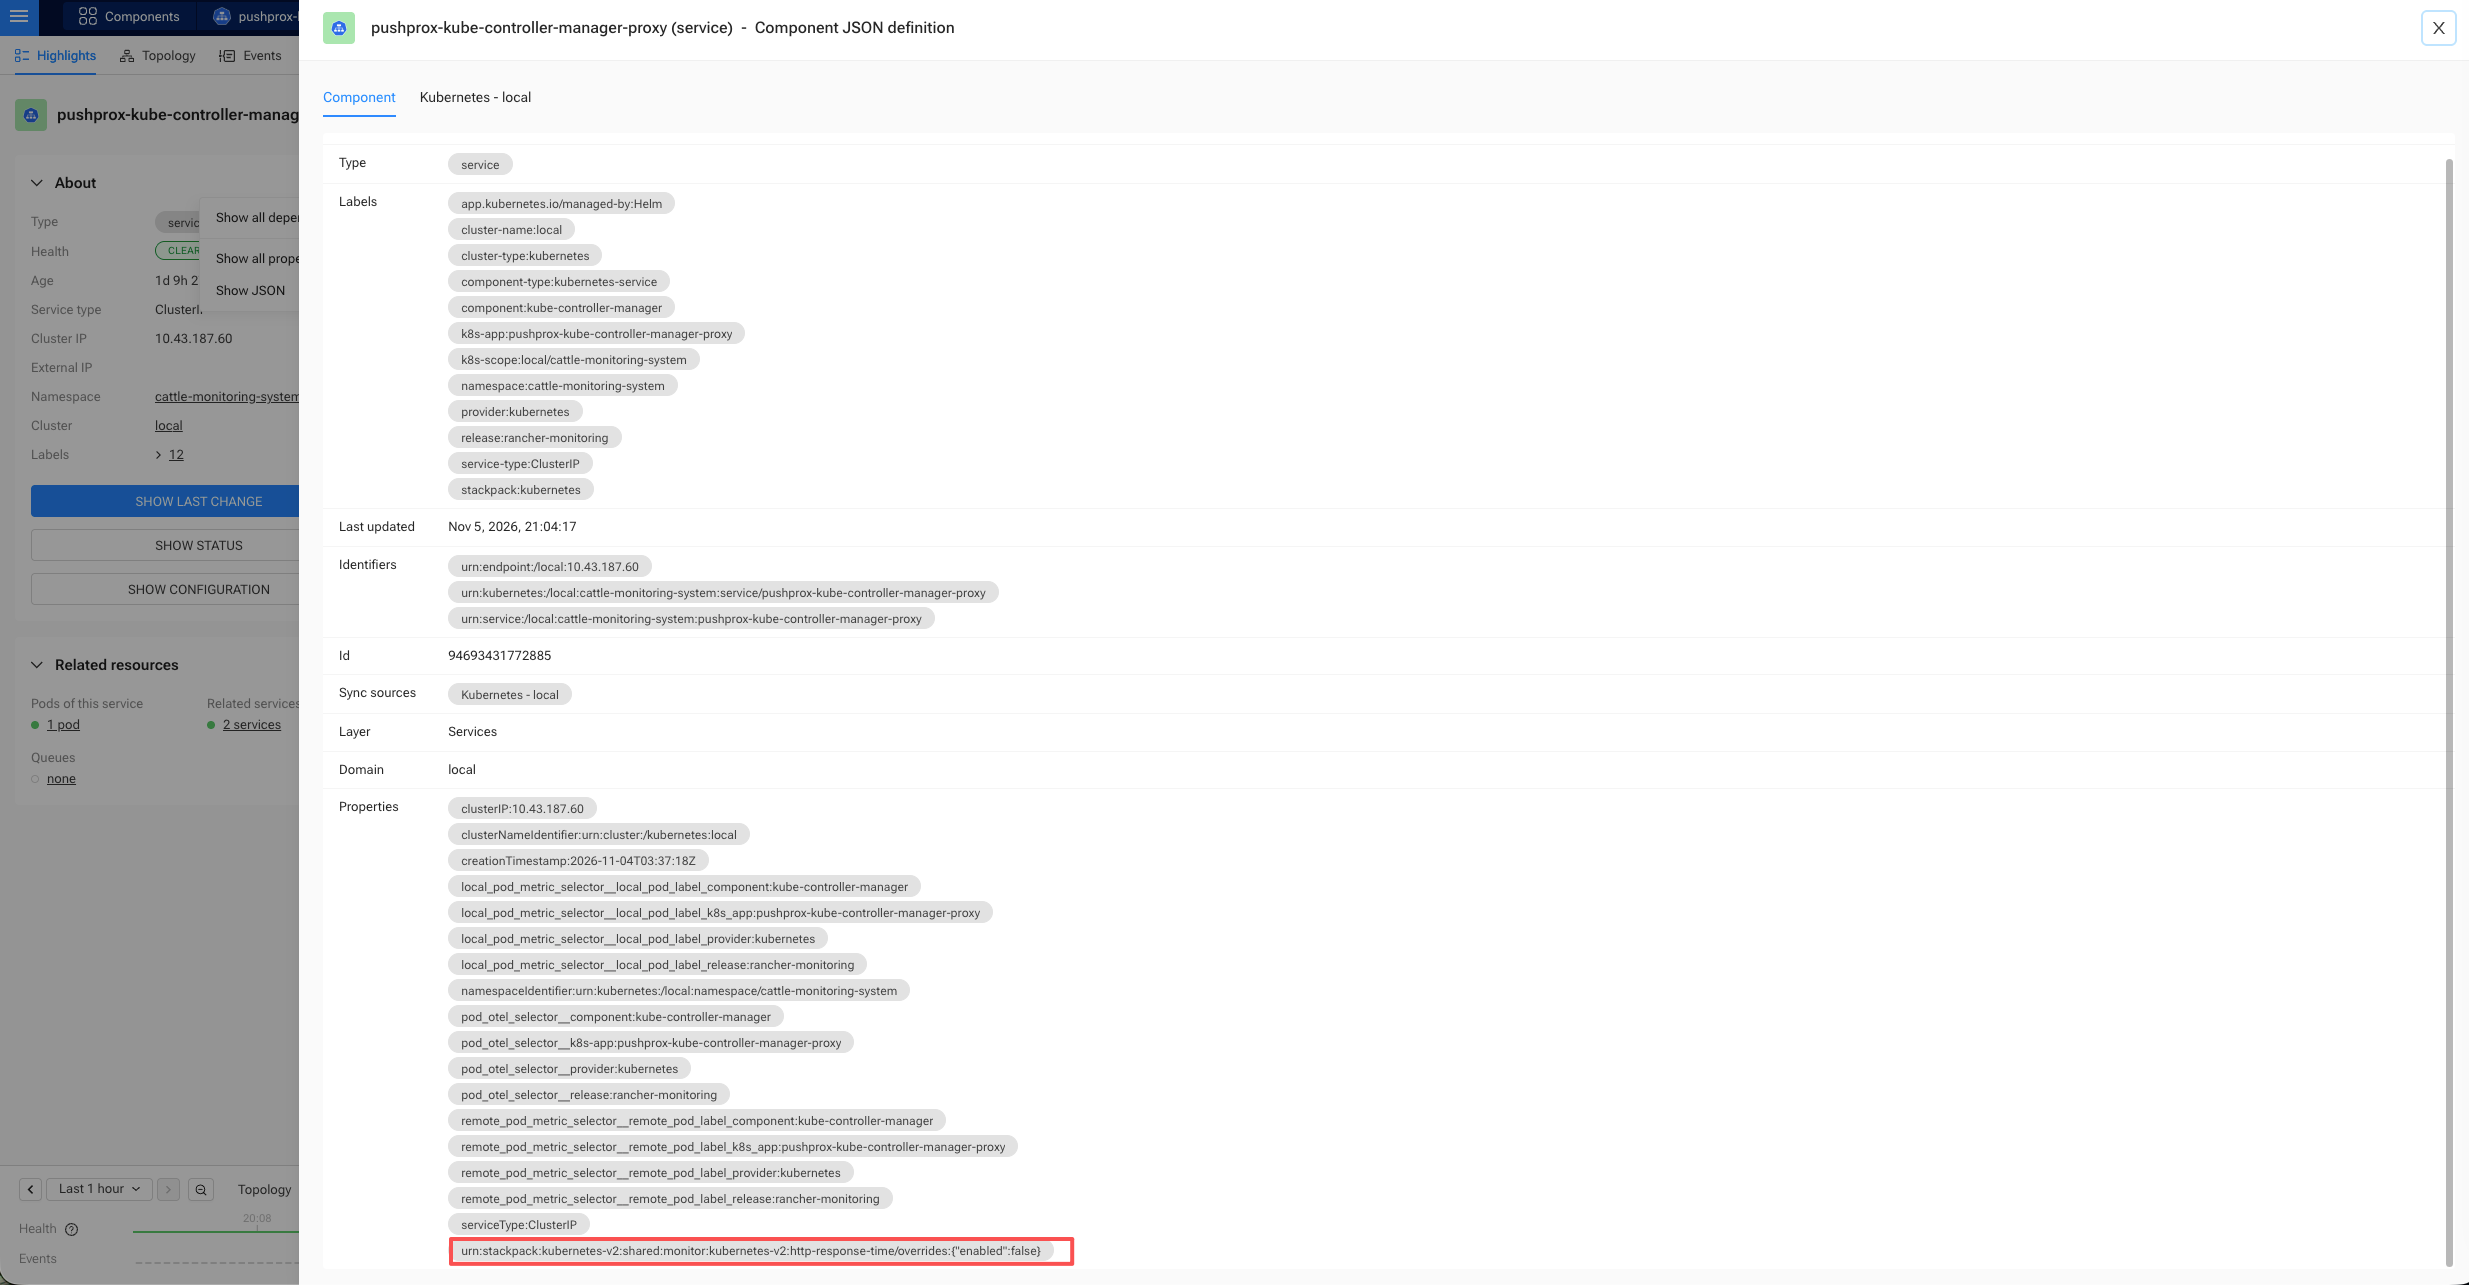
添加 Annotation 后,可以在 Service 的 Properties 中查看对应的配置标识:
SUSE Observability 中部分 Service 显示 Critical
https://warnerchen.github.io/2026/11/05/SUSE-Observability-中部分-Service-显示-Critical/