外部防火墙检测到 RKE2 Cilium 集群内部流量
在 RKE2 Cilium 集群中,发现外部防火墙捕获到了原本属于集群内部 Pod CIDR / Cluster CIDR 的流量,主要涉及以下两种场景:
- Pod IP -> CoreDNS Cluster IP
- 节点 IP -> 不存在的 Pod / Cluster IP
Pod IP -> CoreDNS Cluster IP
集群中的 CoreDNS Cluster IP 为 10.43.0.10。通过分析 PCAP 抓包文件,可以观察到部分报文的 Info 字段显示为 Destination unreachable (Port unreachable),对应 ICMP Type 3 Code 3:
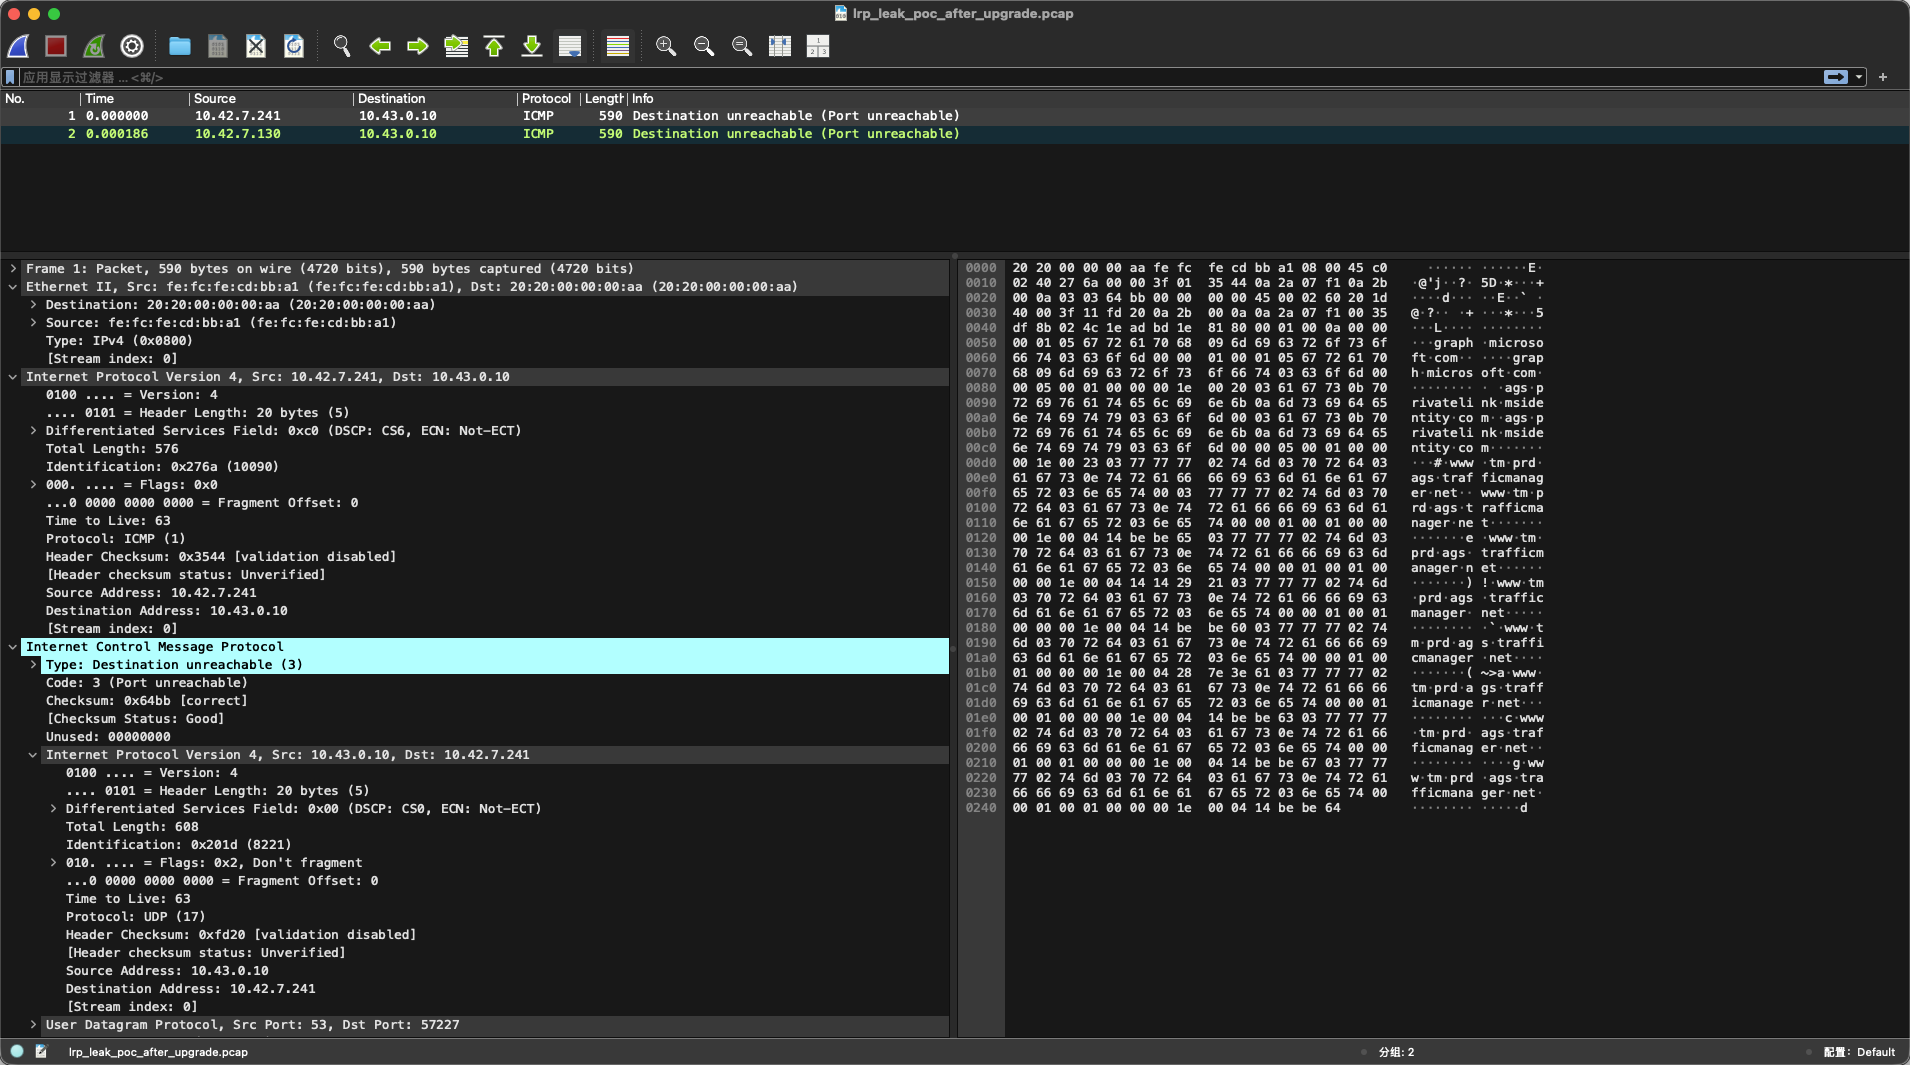
该 ICMP 错误报文表示 IP 数据包已经到达目标主机,但目标主机上没有对应的 UDP 端口接收该数据包,因此返回了端口不可达的 ICMP 错误报文。
根本原因
当 Pod 向 10.43.0.10:53 发送 UDP DNS 请求时,Cilium 会通过 Service DNAT 将请求转发至 CoreDNS 后端,并维护用于处理响应流量的反向 NAT 状态。
但是,该过程不会为以下流量路径创建出口 SNAT 映射:
1 | Pod:<UDP Port> -> 10.43.0.10:53 |
当 DNS 响应到达 Pod 时,如果对应的 UDP Socket 已经不存在,Pod 就会生成 ICMP Type 3 Code 3 错误报文。
该 ICMP 错误报文中引用的原始数据包为:
1 | 10.43.0.10:53 -> Pod:<UDP Port> |
在出口 SNAT 处理过程中,Cilium 会根据 ICMP 错误报文中引用的原始数据包信息,尝试查找对应的 NAT 映射。
但是,由于不存在与以下流量路径匹配的 SNAT 记录:
1 | Pod:<UDP Port> -> 10.43.0.10:53 |
因此,Cilium 不会对该 ICMP 错误报文执行地址改写。
与此同时,Cilium 的 Service 负载均衡逻辑会跳过 ICMP 报文,因此该 ICMP 报文也不会通过 Service DNAT 转发至 CoreDNS 后端。
由于集群节点上不存在通往 10.43.0.10 的专用路由,该 ICMP 报文最终会匹配宿主机的默认路由,通过物理网卡发送至集群外部,从而被外部防火墙捕获。
相关 Cilium 源码分析:
ICMP 报文返回
DROP_UNSUPP_SERVICE_PROTO,表示 ICMP 不属于 Service 负载均衡路径支持的协议:https://github.com/cilium/cilium/blob/v1.19.0/bpf/lib/lb.h#L1562-L1580收到
DROP_UNSUPP_SERVICE_PROTO后,Cilium 会跳过 Service 查询,不会通过 DNAT 将该 ICMP 报文转发至 CoreDNS 后端:https://github.com/cilium/cilium/blob/v1.19.0/bpf/bpf_lxc.c#L165-L175Cilium 识别出 ICMP 错误报文后,会进入相应的处理分支:https://github.com/cilium/cilium/blob/v1.19.0/bpf/lib/nat.h#L1009-L1025
Cilium 读取 ICMP 错误报文中引用的原始 DNS 响应,并根据其中的信息查找对应的 SNAT 记录。如果未找到匹配的记录,则返回
NAT_PUNT_TO_STACK:https://github.com/cilium/cilium/blob/v1.19.0/bpf/lib/nat.h#L842-L889在物理网卡的出口处理路径中,
NAT_PUNT_TO_STACK会被转换为CTX_ACT_OK,允许报文继续沿宿主机已选择的出口路径发送。由于宿主机没有通往10.43.0.10的专用路由,报文最终通过默认路由转发至集群外部:https://github.com/cilium/cilium/blob/v1.19.0/bpf/lib/nodeport_egress.h#L391-L411
Pod 为什么会在收到 DNS 响应之前关闭 UDP Socket
Pod 在收到 DNS 响应之前关闭 UDP Socket,可能由多种原因导致,常见情况包括:
- 应用进程主动取消 DNS 请求。
- 应用进程发生崩溃、退出或重启。
- 应用在发送 DNS 请求后立即关闭 UDP Socket。
- DNS 请求超时,应用进程关闭原有的 UDP Socket,并使用新的 UDP Socket 发起重试请求。
排查方法
如果需要进一步确认 Pod 提前关闭 UDP Socket 的具体原因,则需要通过多点抓包进行分析。
问题环境中启用了 NodeLocalDNS,并通过 Cilium LRP 将 Pod 发出的 DNS 流量转发至对应的 Backend。
根据 ICMP 错误报文中引用的原始 DNS 数据包,可以确认 Pod 查询的均为集群外部域名。
因此,需要在以下网络位置同步进行抓包,以分析 DNS 请求、响应及 ICMP 错误报文的完整传输过程。
1. Pod 的网络命名空间
1 | nsenter -t <Pod 容器在宿主机上的 PID> -n \ |
用于观察 Pod 发起的首次 DNS 查询、更换 UDP 源端口后的重试请求、DNS 响应,以及 Pod 生成的 ICMP 错误报文。
2. Pod 所在节点的 NodeLocalDNS 网络命名空间
1 | nsenter -t <NodeLocalDNS 容器在宿主机上的 PID> -n \ |
用于观察以下 DNS 流量:
- Pod <-> NodeLocalDNS
- NodeLocalDNS <-> 外部上游 DNS
- NodeLocalDNS <-> CoreDNS
3. 节点出口网卡
1 | tcpdump -ni <节点的出口网卡> -s0 -B 4096 -U \ |
用于观察经过节点 SNAT 后发出的 DNS 查询,以及从外部返回节点的 DNS 响应。
4. 上游 DNS 服务器
1 | tcpdump -ni any -s0 -B 4096 -U \ |
用于确认上游 DNS 服务器是否收到查询请求、是否返回响应,以及是否继续向其他 DNS 服务器发起查询。
暂不限制客户端源 IP,以免遗漏经过中间网络设备再次 SNAT 后的流量。
5. 节点与上游 DNS 之间的其他网络设备
如果节点与上游 DNS 服务器之间还经过其他网络设备,则需要在这些设备上同步进行抓包:
1 | # 靠近节点侧的网络接口 |
结论
经过对实际问题环境的多轮抓包分析,最终确认 NodeLocalDNS 在接收到 DNS 查询请求和响应后,均会立即进行转发,未发现明显的处理延迟。大部分延迟发生在上游 DNS 服务器处理 DNS 查询的过程中。
由于上游 DNS 响应时间过长,Pod 会关闭最初用于 DNS 查询的 UDP Socket,并使用新的 UDP 源端口重新发起 DNS 查询。
当原始 DNS 查询对应的延迟响应最终到达 Pod 的网络命名空间时,原有的 UDP Socket 已经不再可用,因此 Pod 会生成 ICMP Type 3 Code 3 错误报文。
随后,由于 Cilium 未对该 ICMP 报文进行地址改写,且宿主机不存在通往 CoreDNS Cluster IP 的专用路由,该报文最终通过宿主机默认路由转发至集群外部,导致外部防火墙捕获到该流量。
Workaround
除了优化上游 DNS 服务器的响应时间外,还可以考虑在 RKE2 侧采用以下方式进行缓解。
方法一:在 NodeLocalDNS 中配置 prefetch 和 serve_stale
prefetch: 在热门 DNS 缓存即将过期时,提前向上游 DNS 服务器发起查询并更新缓存。serve_stale: 允许 NodeLocalDNS 在缓存过期后继续返回旧的 DNS 记录。
但这两种配置也存在一定的局限性:
prefetch: 会增加上游 DNS 查询量,且只有满足热门缓存条件的域名才会触发预取。serve_stale: 可能返回已经发生变化的 DNS 记录,导致客户端获取到过期的解析结果。
方法二:调整 Application 的 DNS 请求等待时间和重试策略
可以考虑由 Application 调整单次 DNS 请求的等待时间及重试策略。
但这种方式同样存在一定的局限性:当真正发生 DNS 故障时,Application 可能需要等待更长时间才能确认请求失败。
节点 IP -> 不存在的 Pod / Cluster IP
集群中的 Pod CIDR 为 10.42.0.0/16,Cluster CIDR 为 10.43.0.0/16。
通过分析防火墙日志,可以发现这类流量基本都是 ICMP 请求报文:
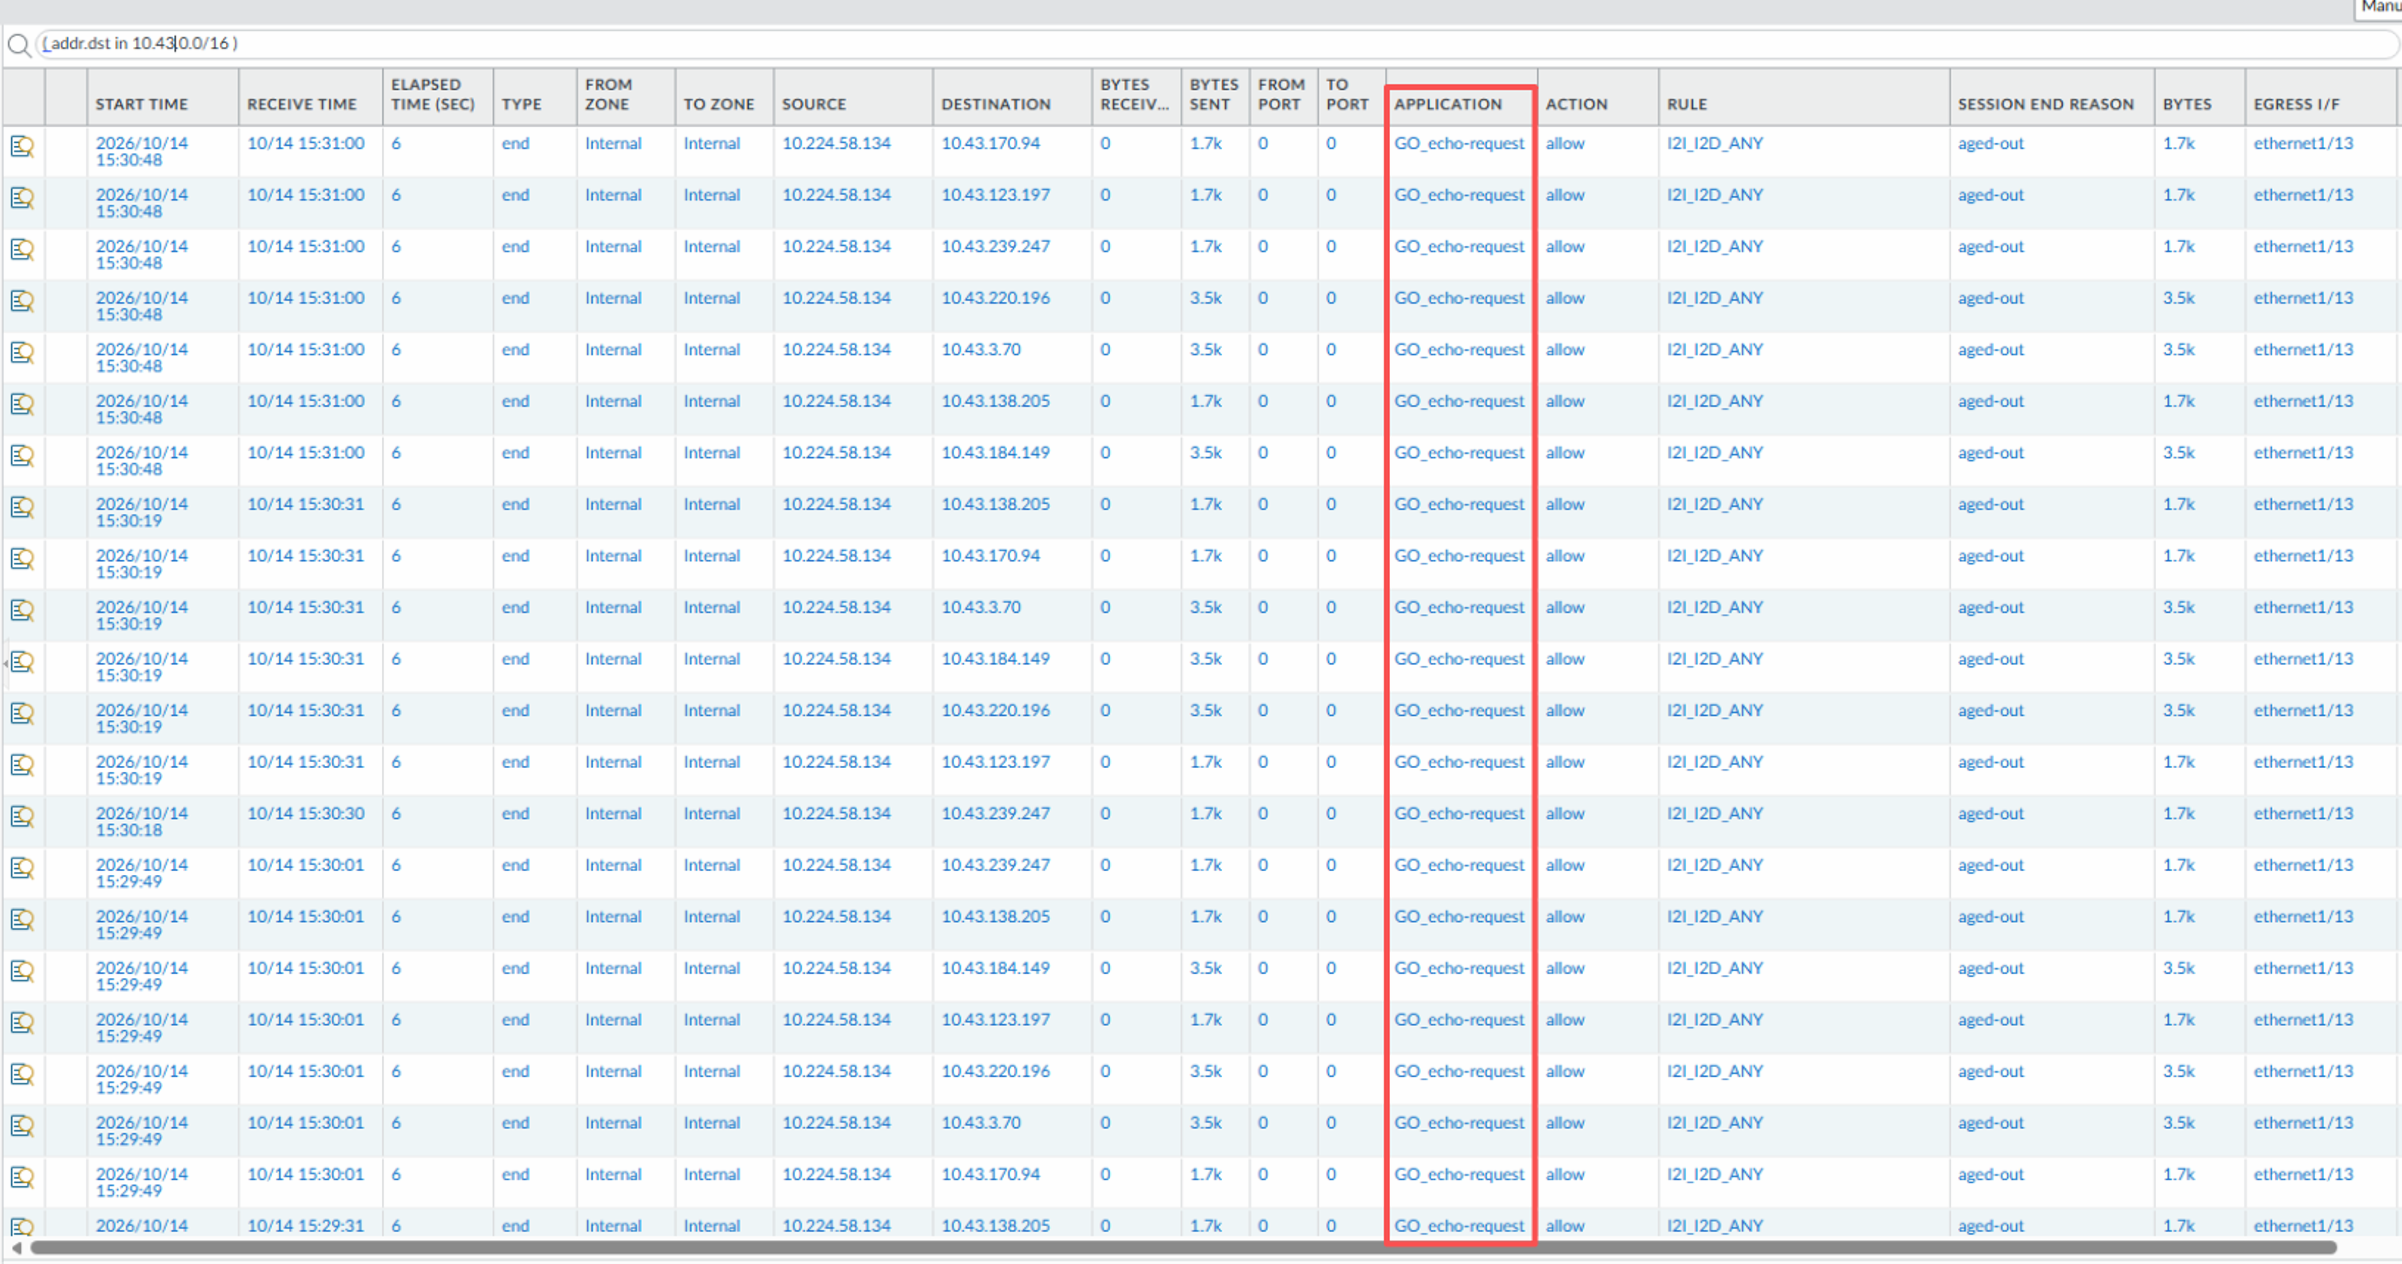
但是,在集群中排查时,无法找到与目标 IP 对应的 Pod 或 Service,说明这些目标 IP 在当前集群中并不存在。
根本原因
主要原因是,节点通常只会为已经分配的 Pod 子网创建对应的路由,例如:
10.42.0.0/2410.42.1.0/24
而不会创建一条覆盖整个 Pod CIDR 的路由。
当目标 IP 属于尚未分配的 Pod 子网,并且节点上不存在其他更具体的路由或丢弃规则时,该报文就会匹配宿主机的默认路由,并被转发至节点网关。
对于不存在的 Service IP,Cilium 没有对应的 Service 条目可用于执行地址转换。
此外,由于这类报文属于 ICMP Echo Request,正如前文所述,ICMP 流量会跳过 Cilium 的 Service 负载均衡查询。
因此,当节点上不存在通往目标 Service IP 的对应路由时,这些 ICMP 报文同样会匹配默认路由,并被转发至集群外部。
在实际环境中,直接向集群内不存在的 Pod / Service IP 发起请求,可以在节点的出口网卡上捕获到对应的流量:
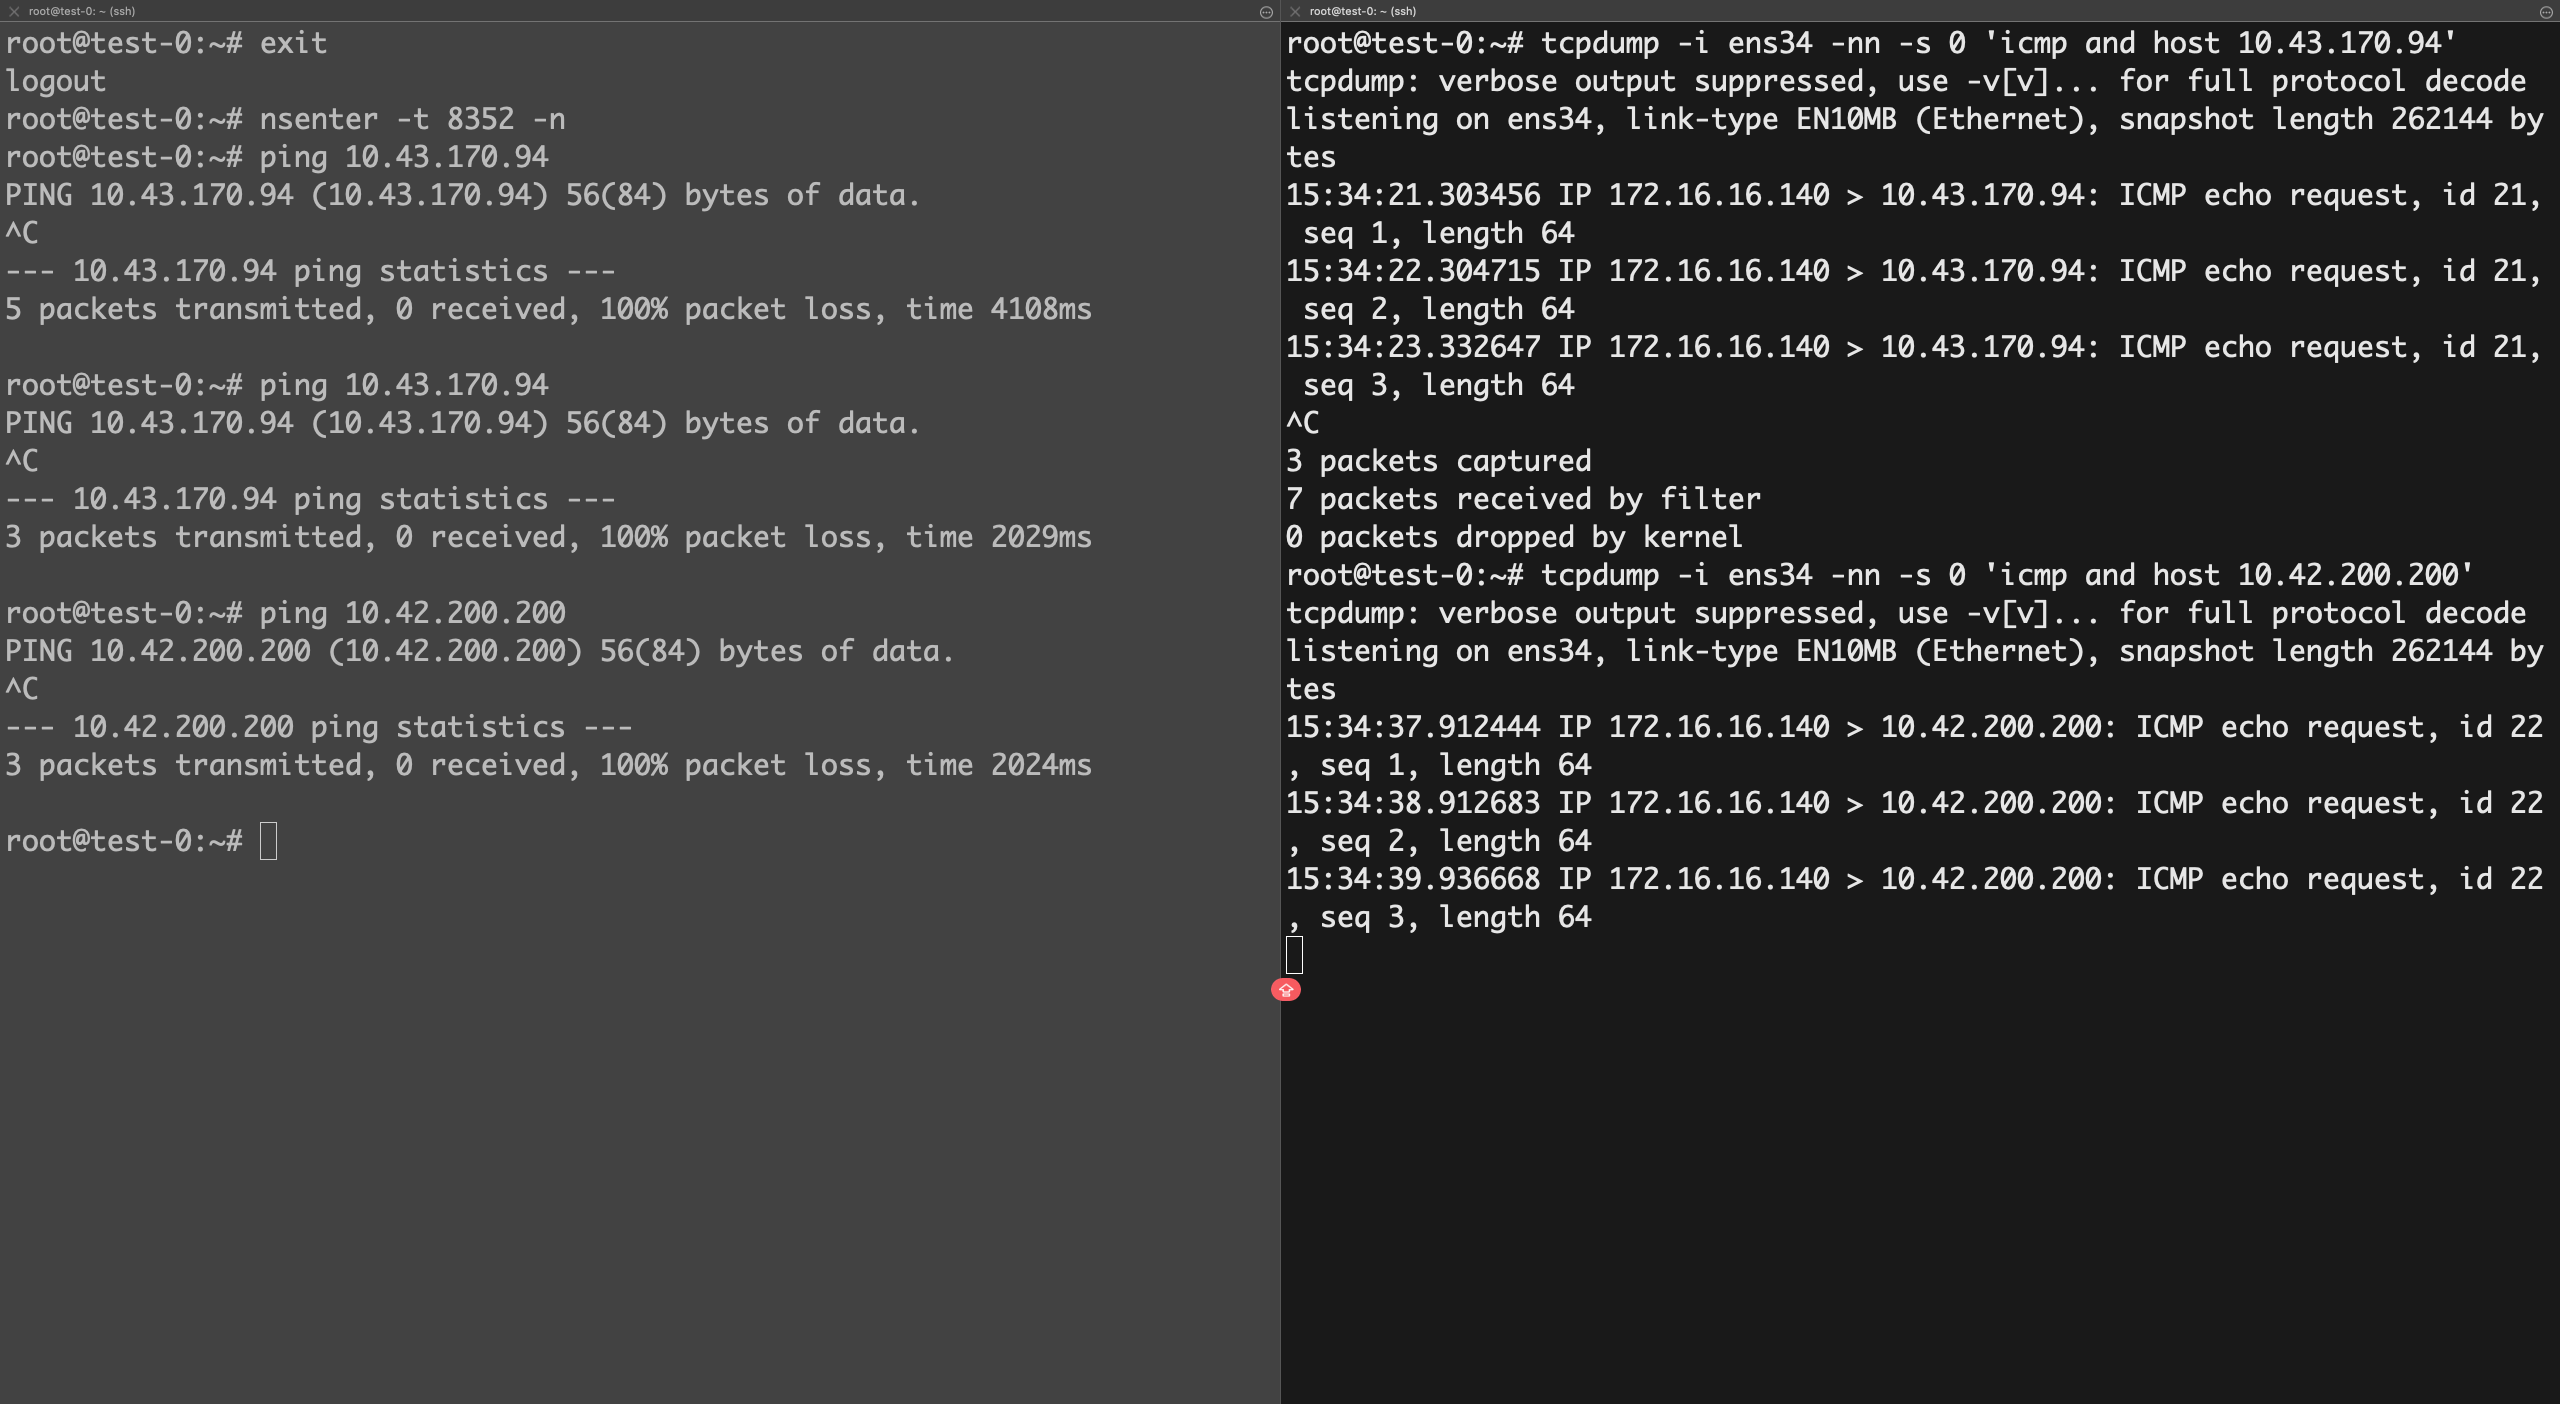
因此,从网络路由和转发机制来看,这种现象属于预期行为。
排查方法
如果需要确认具体是哪些 Pod 正在向不存在的 IP 地址发送请求,可以通过 Cilium Hubble 进一步排查:
1 | kubectl -n kube-system exec <cilium_pod_name> -c cilium-agent -- \ |
Workaround
如果这些流量是某些 Pod 的预期行为,可以尝试使用 CiliumNetworkPolicy 来避免这类流量经过出口网卡:
1 | apiVersion: cilium.io/v2 |
外部防火墙检测到 RKE2 Cilium 集群内部流量
https://warnerchen.github.io/2026/11/12/外部防火墙检测到-RKE2-Cilium-集群内部流量/